Jira Data Center in Claude, ChatGPT und jedem MCP-Client. Für Ihr ganzes Team.
Vorgänge per JQL, Kommentare, Arbeitsprotokolle, Projekte, Boards und Sprints. Ein Token in Loopthink, ein Login pro Person, Rollen pro Tool und ein Audit-Eintrag für jeden Aufruf.
Kostenlos für 2 Connectors, ohne Karte · Pro 19 € · in der EU betrieben · 18 Lese-Tools, 4 Schreib-Tools standardmäßig aus
“Welche Vorgänge im Projekt SHOP sind überfällig und noch nicht erledigt?”
Drei Vorgänge in SHOP sind überfällig und noch offen:
| Vorgang | Zusammenfassung | Status | Fällig |
|---|---|---|---|
| SHOP-1482 | Checkout bricht bei PayPal Express ab | In Review | 16.10.2026 |
| SHOP-1490 | Staffelpreise für Nordwind Handel | In Arbeit | 20.10.2026 |
| SHOP-1503 | Export der Rechnungen an DATEV | Offen | 22.10.2026 |
- nur lesend
- maskiert
Ein Token rein, die Tools kommen raus.
Jira Data Center ist das Werkzeug, mit dem viele größere Unternehmen im DACH-Raum ihre Projekte auf eigenen Servern steuern: Vorgänge mit ihrer ganzen Historie, Kommentare, Arbeitsprotokolle, Versionen, Komponenten, Boards und Sprints. Mit JQL findet man alles, sobald man die Feldnamen und die Syntax kennt; außerhalb des Entwicklerteams kennen sie die wenigsten.
KI-Anbindungen für Jira decken meist nur die Cloud-Version ab, Teams auf Data Center gehen leer aus. Mit dem Jira-Data-Center-Connector fragen Produkt, Entwicklung, Projektleitung und Geschäftsführung in Claude oder ChatGPT und bekommen die Antwort aus der eigenen Instanz. Loopthink hält einen persönlichen Zugriffstoken eines Jira-Benutzers, jede Person meldet sich mit ihrer eigenen Identität an, und jeder Aufruf wird unter ihrem Namen protokolliert.
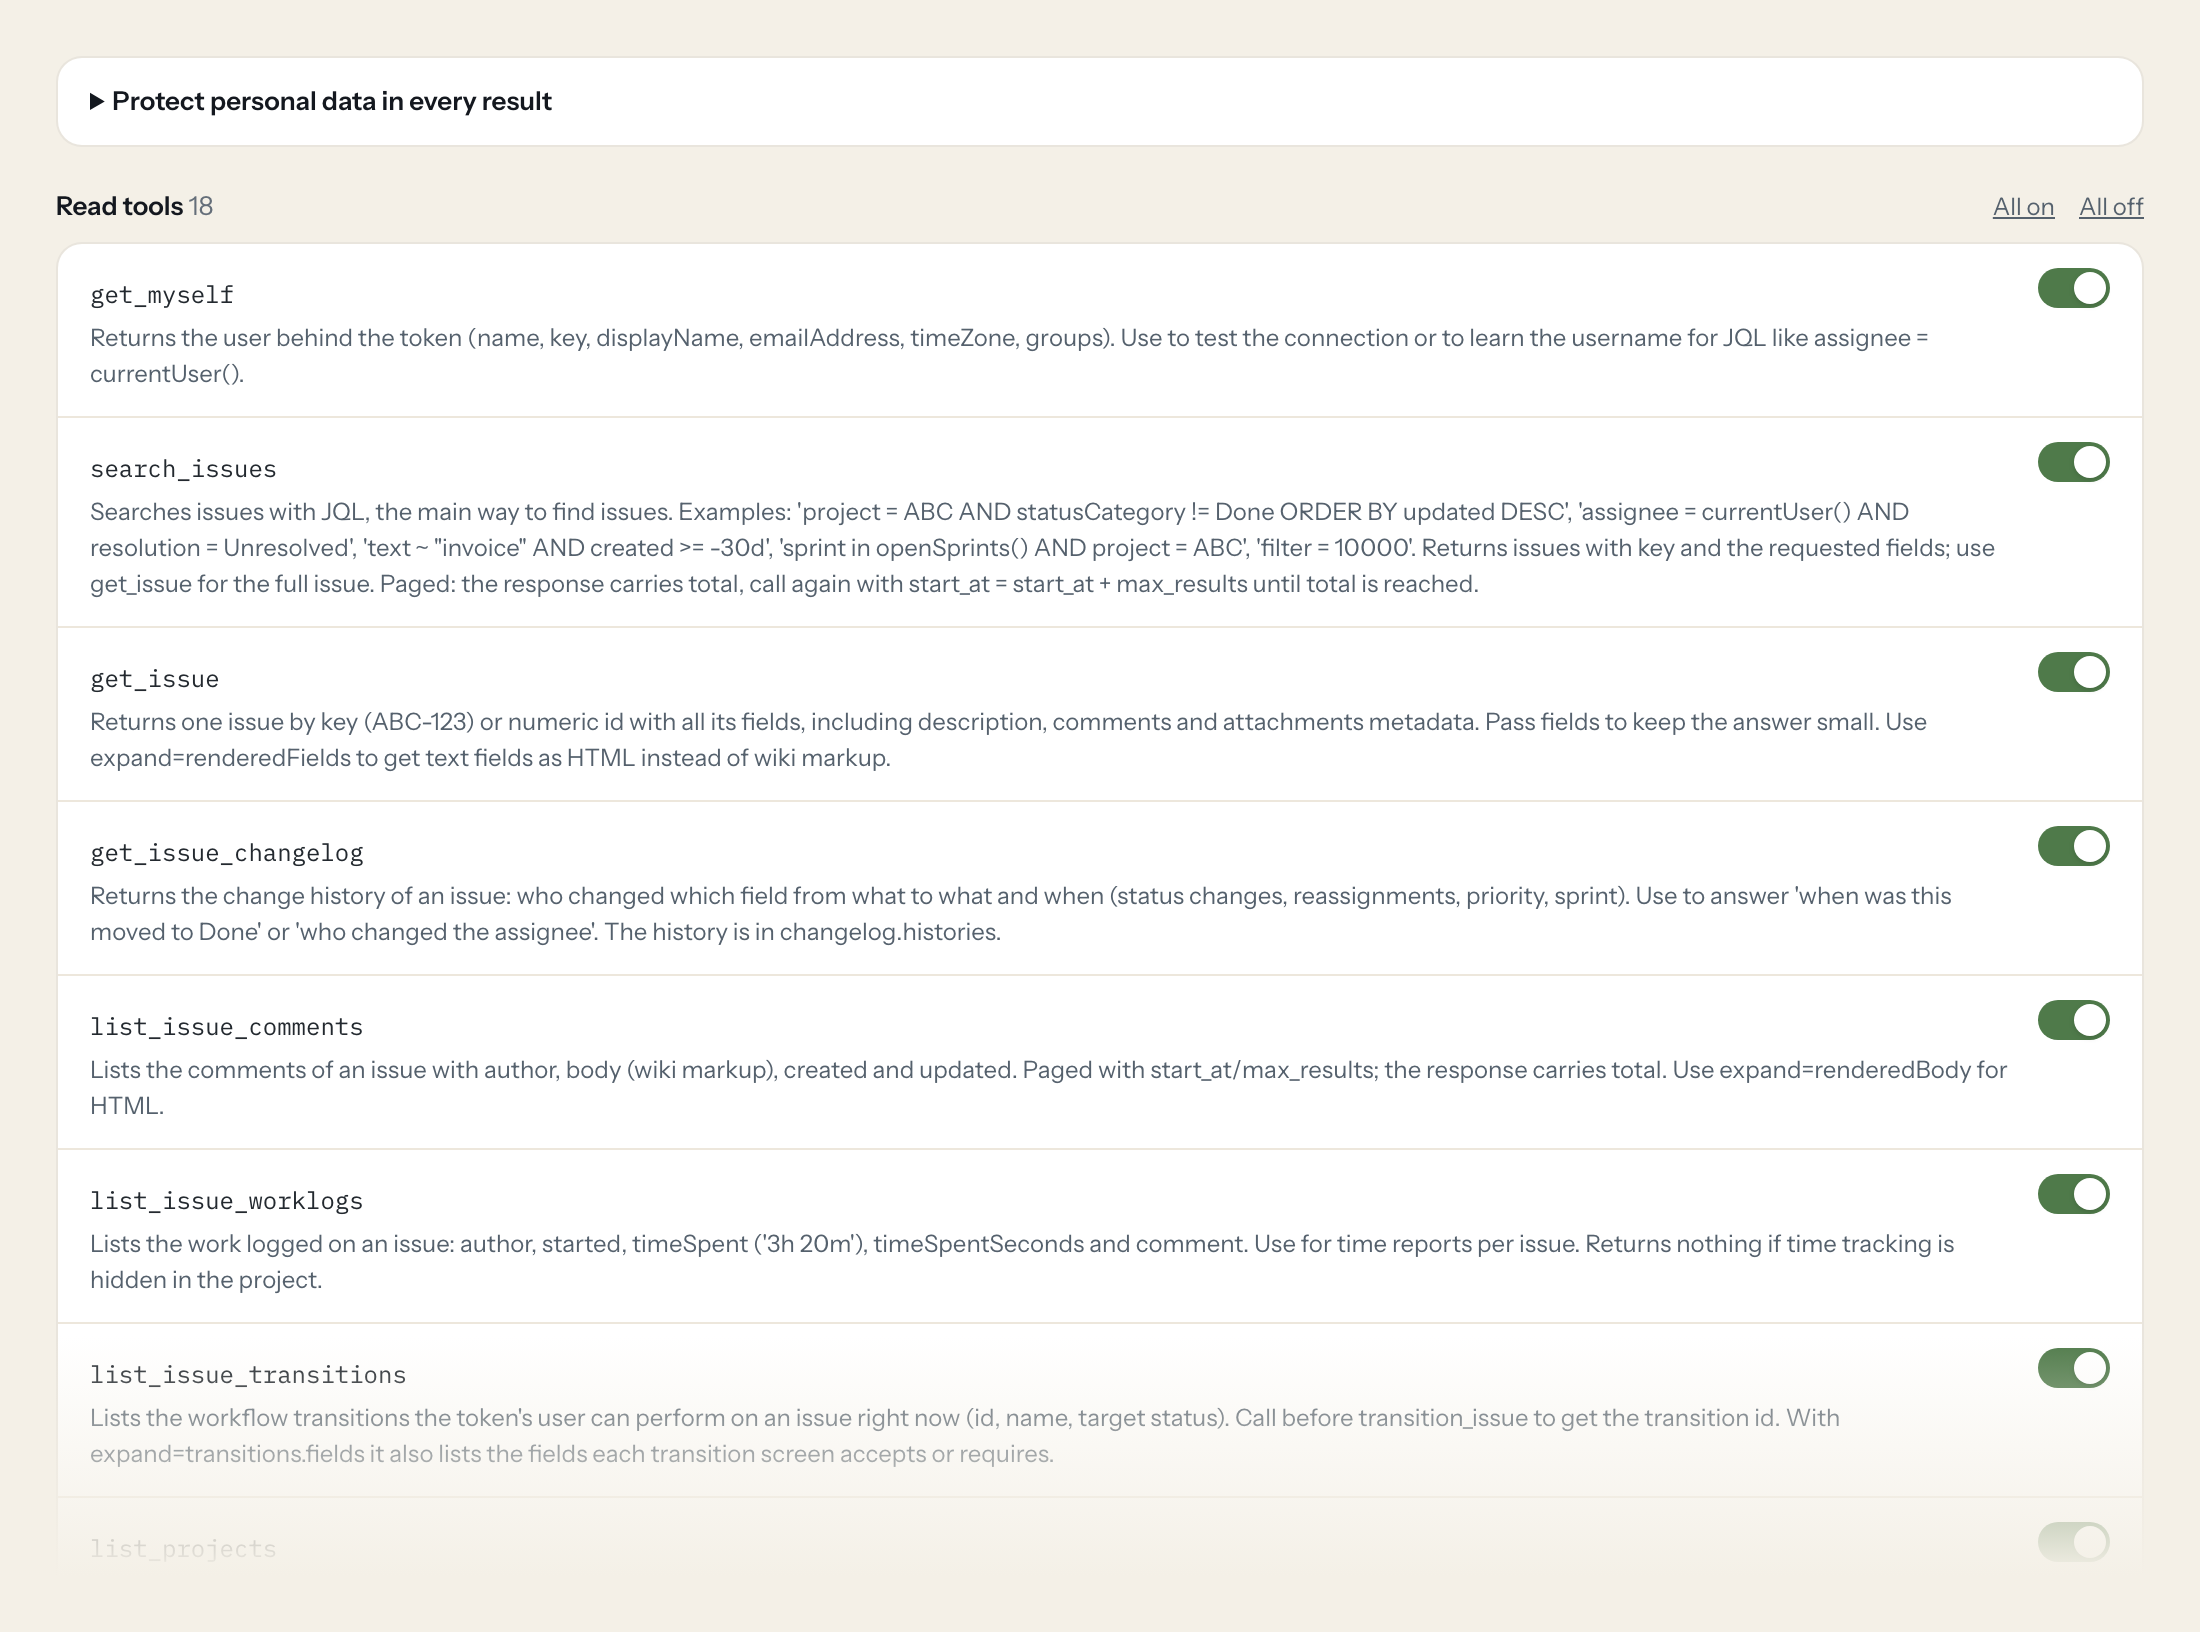
Achtzehn Lese-Tools decken JQL-Suche, Vorgänge, Änderungshistorie, Kommentare, Arbeitsprotokolle, Übergänge, Projekte, Versionen, Komponenten, Status, Benutzer, Felder, gespeicherte Filter, Boards und Sprints ab. Vier Schreib-Tools, ein Kommentar, ein neuer Vorgang, ein Statusübergang und ein Arbeitsprotokoll, bleiben aus, bis Sie sie für eine Rolle einschalten.
- Projektleitung
“Welche Vorgänge im Projekt SHOP sind überfällig und noch nicht erledigt?”
Beantwortet von
search_issues - Entwicklung
“Was ist im aktuellen Sprint des Platform-Boards noch offen, und wer hat es?”
Beantwortet von
list_sprint_issues - Produkt
“Wann ging SHOP-1482 auf In Review, und wer hat die Priorität geändert?”
Beantwortet von
get_issue_changelog - Geschäftsführung
“Wie viele Stunden wurden bisher auf SHOP-1490 gebucht, und von wem?”
Beantwortet von
list_issue_worklogs - Produkt
“Welche Versionen von SHOP sind überfällig und noch nicht veröffentlicht?”
Beantwortet von
list_project_versions - Entwicklung
“Kommentiere SHOP-1482: Fix ist auf Staging, bitte erneut testen.”
Beantwortet von
add_comment
Was der Jira Data Center-Connector kann.
| Tool | Was es tut | Zugriff | Standard |
|---|---|---|---|
| get_myself | Returns the user behind the token (name, key, displayName, emailAddress, timeZone, groups). Use to test the connection or to learn the username for JQL like assignee = currentUs… | Lesen | An |
| search_issues | Searches issues with JQL, the main way to find issues. Examples: 'project = ABC AND statusCategory != Done ORDER BY updated DESC', 'assignee = currentUser() AND resolution = Unr… | Lesen | An |
| get_issue | Returns one issue by key (ABC-123) or numeric id with all its fields, including description, comments and attachments metadata. Pass fields to keep the answer small. | Lesen | An |
| get_issue_changelog | Returns the change history of an issue: who changed which field from what to what and when (status changes, reassignments, priority, sprint). Use to answer 'when was this moved… | Lesen | An |
| list_issue_comments | Lists the comments of an issue with author, body (wiki markup), created and updated. Paged with start_at/max_results; the response carries total. | Lesen | An |
| list_issue_worklogs | Lists the work logged on an issue: author, started, timeSpent ('3h 20m'), timeSpentSeconds and comment. Use for time reports per issue. | Lesen | An |
| list_issue_transitions | Lists the workflow transitions the token's user can perform on an issue right now (id, name, target status). Call before transition_issue to get the transition id. | Lesen | An |
| list_projects | Lists all projects the user can browse (id, key, name, projectTypeKey). Call first to get a project key for JQL or the other project tools. | Lesen | An |
| get_project | Returns one project by key or id: name, description, lead, issue types, components, versions and roles. | Lesen | An |
| list_project_versions | Lists the versions (releases) of a project with name, released, archived, releaseDate and overdue. Use for fixVersion JQL and release questions. | Lesen | An |
| list_project_components | Lists the components of a project with name, description and lead. Use for component JQL. | Lesen | An |
| list_project_statuses | Lists the issue types of a project, each with the statuses its workflow uses. Use to write correct status names in JQL or to explain a workflow. | Lesen | An |
| search_users | Finds users by username, name or email fragment. Returns name (the username used in JQL and in assignee fields), key, displayName and emailAddress. | Lesen | An |
| list_fields | Lists all system and custom fields with id (customfield_10010), name, whether it is custom, and the JQL clause names. Use to translate a field name like 'Story Points' into the… | Lesen | An |
| list_favourite_filters | Lists the saved filters the user marked as favourite, each with id, name, owner and its jql. Run a filter with search_issues and jql 'filter = <id>' or its jql. | Lesen | An |
| list_boards | Lists Jira Software boards (id, name, type scrum or kanban). Use to find the board id for list_board_sprints. | Lesen | An |
| list_board_sprints | Lists the sprints of a scrum board with id, name, state, startDate, endDate, completeDate and goal. Filter with state=active to find the current sprint. | Lesen | An |
| list_sprint_issues | Lists the issues in a sprint, optionally narrowed by JQL (e.g. 'statusCategory != Done'). | Lesen | An |
| add_comment | WRITE: Adds a comment to an issue as the token's user. The body is Jira wiki markup (*bold*, {code}...{code}, [~username] mentions notify that user). | Schreiben | Aus |
| create_issue | WRITE: Creates an issue in a project. Needs project key, issue type name (e.g. | Schreiben | Aus |
| transition_issue | WRITE: Moves an issue through its workflow (e.g. to In Progress or Done). | Schreiben | Aus |
| log_work | WRITE: Logs time spent on an issue as the token's user. time_spent uses Jira duration syntax ('1h 30m', '2d'); started is when the work began. | Schreiben | Aus |
Schreib-Tools sind für jede Rolle aus, bis Sie sie einschalten, ein Tool für eine Rolle. Die Namen und Beschreibungen sind das, was das Modell sieht, deshalb bleiben sie englisch; es bekommt außerdem die vollständige Parameterbeschreibung jedes Tools.
So kommen Sie an den Jira Data Center-Token.
Fünf Minuten, einmalig. Niemand in Ihrem Team sieht ihn je.
- 1
In Jira als der Benutzer anmelden, in dessen Namen die KI handeln soll (am besten ein eigener technischer Benutzer mit Durchsuchen-Berechtigung auf genau den Projekten, die die KI lesen darf).
- 2
Auf den Avatar (oben rechts) > Profil klicken, dann im linken Menü Persönliche Zugriffstoken öffnen.
- 3
Auf Token erstellen klicken, einen Namen und eine Gültigkeit in Tagen eingeben (Ihr Admin kann ein Maximum vorgeben, standardmäßig 365 Tage), dann Erstellen.
- 4
Den Token sofort kopieren. Nach dem Schließen des Dialogs wird er nicht mehr angezeigt.
- 5
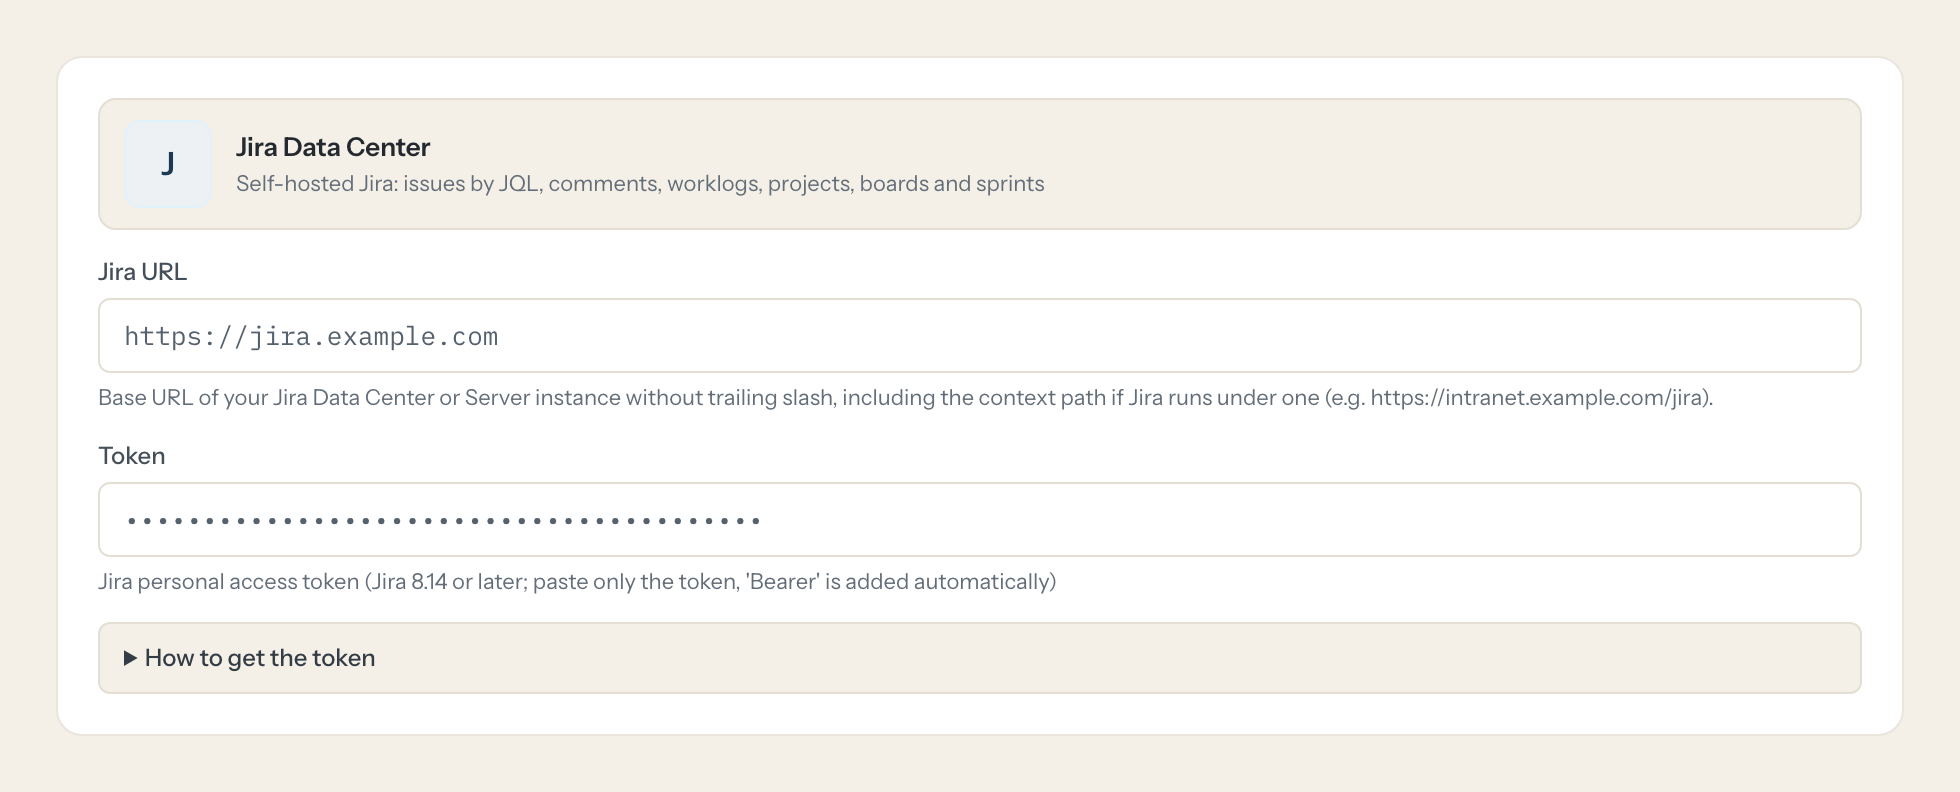
In Loopthink fügen Sie Jira Data Center aus dem Katalog hinzu und fügen den Token ein. Außerdem fragt der Connector nach jira url. Eine Minute später sieht Ihr Team die Tools.
Persönliche Zugriffstoken gibt es ab Jira 8.14 (Jira Service Management 4.15). Sie haben keine Scopes: Ein Token handelt mit allen Rechten seines Benutzers. Geben Sie dem technischen Benutzer nur die Projektrollen, die die KI braucht; die Schreib-Tools brauchen zusätzlich die passenden Projektberechtigungen (Kommentare hinzufügen, Vorgänge erstellen, Vorgänge weiterleiten, An Vorgängen arbeiten). Admins können Token über die Systemeigenschaften atlassian.pats.* abschalten oder ihre Laufzeit begrenzen. Boards und Sprints brauchen Jira Software.
Was wir in Jira Data Center zu maskieren empfehlen.
Vorgänge enthalten Personen und Freitext: Autor, Bearbeiter, Verfasser von Kommentaren mit Namen und E-Mail-Adressen, dazu Beschreibungen, die oft Kunden zitieren. Die vorgeschlagenen Felder maskieren Namen, E-Mail-Adressen, Kommentartexte und Beschreibungen für Rollen, die nur Status, Termine und Zahlen brauchen; das Team, das die Vorgänge bearbeitet, bekommt eine Rolle ohne diese Regel.
- displayName
- emailAddress
- name
- key
- author
- updateAuthor
- creator
- reporter
- assignee
- lead
- owner
- body
- comment
- description
- avatarUrls
- timeZone
Jira Data Center und Loopthink
- Welchen Jira-Benutzer und welche Berechtigungen braucht der Token?
- Einen persönlichen Zugriffstoken, verfügbar ab Jira 8.14. Er hat keine Scopes und handelt mit allen Rechten seines Benutzers, legen Sie ihn also unter einem technischen Benutzer an, der genau die Projekte durchsuchen darf, die die KI lesen soll. Die Schreib-Tools brauchen in diesen Projekten zusätzlich Kommentare hinzufügen, Vorgänge erstellen, Vorgänge weiterleiten oder An Vorgängen arbeiten. Boards und Sprints brauchen Jira Software.
- Atlassian hat das Ende von Data Center angekündigt. Lohnt sich das noch?
- Atlassian hat das Ende des Supports für Data Center für März 2029 angekündigt. Bis dahin liegen in Ihrer Instanz die Vorgänge, an denen Ihre Teams jeden Tag arbeiten, und der Connector macht sie schon jetzt in Claude und ChatGPT nutzbar, ohne Migration. Wechseln Sie später in die Cloud, bleiben Rollen, Maskierungsregeln und Audit-Log in Loopthink erhalten.
- Unser Jira läuft im eigenen Rechenzentrum. Erreicht der Connector es?
- Die Instanz muss aus dem Internet per HTTPS erreichbar sein, zum Beispiel über Ihren Reverse Proxy. Ist sie nur im eigenen Netz erreichbar, sagen Sie uns Bescheid, dann schauen wir es uns mit Ihnen an.
- Kann die KI Vorgänge ändern?
- Nur wenn Sie es erlauben. Die vier Schreib-Tools sind standardmäßig aus. Für eine Rolle eingeschaltet, handeln sie als Benutzer des Tokens, und jeder Aufruf wird mit dem Namen der Person protokolliert, die gefragt hat.
- Braucht jedes Teammitglied einen eigenen Jira Data Center-Account?
- Nein. Loopthink hält einen Schlüssel oder Token für Jira Data Center. Ihre Leute melden sich mit ihrer eigenen Identität bei Loopthink an, und jeder Aufruf an Jira Data Center wird unter ihrem Namen protokolliert. Die Lizenzen in Jira Data Center bleiben, wie sie heute sind.
- Wo liegt der Jira Data Center-Schlüssel?
- In Loopthink, verschlüsselt, in der EU. Er erreicht weder den KI-Client noch die Personen, die den Connector nutzen. Rotieren Sie ihn in Jira Data Center, wann immer Sie wollen, und fügen Sie den neuen einmal ein.
- Kann jemand aus dem Chat heraus in Jira Data Center schreiben?
- Nur, wenn Sie es einschalten. Schreibaktionen sind eine eigene Zeile in der Rechtematrix und für jede Rolle standardmäßig aus. Braucht eine Rolle ein Schreib-Tool, geben Sie genau dieses eine Tool genau dieser Rolle frei.
- Was sieht das Modell?
- Das Ergebnis des Tool-Aufrufs, nach der Maskierung. Felder, die Sie als personenbezogen markieren, etwa E-Mail-Adressen, Namen oder Kartendaten, werden maskiert, bevor die Antwort zu den KI-Client reist. Das Modell bekommt die Zahlen, nicht die Menschen.
- Was kostet es?
- Kostenlos für eine Person und zwei Connectors, ohne Karte. Pro kostet 19 € im Monat für bis zu fünf Personen und jeden Connector auf dieser Seite, mit Rollen, feldgenauer Maskierung und 30 Tagen Audit-Log. Team kostet 49 € für zehn Personen und bringt Ihre eigenen REST-APIs und SQL-Datenbanken, Ihre eigene Domain und Ihren eigenen Identity Provider dazu. Kein Gespräch nötig.
Hängen Sie fest, oder fehlt ein Tool? Ein Mensch, der diesen Connector kennt, antwortet innerhalb eines Arbeitstags.

